歩行を学習させる(強化学習)#
第13章の四脚は、強化学習で学習した方策で歩きます。紙面の都合で 本には載せられなかった学習まわりを、ここでまとめてサポートします。 強化学習とは何か、使っている道具(PPO・MuJoCo・mjlab)が何かは そもそも強化学習とは にまとめました。
ブラウザで歩かせてみる#
学習済み方策を、物理シミュレータ MuJoCo の WebAssembly 版(ブラウザの中で 動く形にしたもの)で動かすシミュレーションです。 実機に書き込むものと同じニューラルネットワークが、ブラウザの中で 50 Hz の制御ループを回しています。前進・旋回の指令をスライダーで変えられます。 「押す」で胴体を横から押すこともできます。「RL 方策(IMU あり)」は IMU で姿勢を見て踏ん張らせる の方策です。
物理は学習したときと同じにしてあります。接地するのは足先の球 4 つだけ、 サーボは位置制御(kp 25・kd 0.5)+ 逆起電力に相当する粘性減衰 + ギアの摩擦で、 指令は 20〜35 ms(実機で測った 27 ms を挟む幅)遅れてサーボに届きます。
注釈
初回は物理エンジン(WebAssembly 版の MuJoCo)とロボットモデルで約 16 MB ダウンロードします。
「制御」の切替で、本文 13.5 の sin/cos 歩行(状態機械 + トロット。対角の
2 本ずつを組にして交互に脚を出す歩き方)と、強化学習(RL, Reinforcement
Learning)の方策を比べられます。sin/cos 側は、遊脚を sin で山なりに持ち上げて、
2 リンクの逆運動学(IK, Inverse Kinematics。足先の位置から関節角を求める
計算、本文 13.3)で関節角に変換するもので、本のサンプルコード
src/gait.cpp + src/leg_ik.cpp をそのままブラウザに移植したものです。
ただ、この機体は前後が非対称なので、進む向きで歩き方がまるで変わります。
同じストライド 0.02 m(スライダー ±0.05)で、前へはほとんど進まず
(0.006 m/s)、後ろへは 0.10 m/s で進みます。前進はスライダー 0.12
(ストライド 0.048 m)で 0.06 m/s、0.15 まで上げると 8 回に 1 回は横倒しに
なります。係数を手で回してもどちらかにしか合わせられない——それが RL に
行く動機です。
そもそも強化学習とは#
強化学習は、正しい動かし方を人が教えるのではなく、ロボットに試行錯誤させて 覚えさせる方法です。うまくいったら点数(報酬)を与え、点数が多くなる 動き方を少しずつ身につけさせます。この四脚の学習では、たとえば次のような 報酬を決めています。
指令された速さで進めたら加点
立っていられたら少し加点。胴体が傾きすぎたり、低くなりすぎたりしたら、 その回はそこで打ち切り
胴体の高さが目標からずれたら減点
関節を必要以上に速く回したり、力を使いすぎたりしたら減点
実機でこれを何度も繰り返すと、時間がかかるうえに機体が壊れます。そこで学習は 物理シミュレーションの中で行い、4096 台のロボットを同時に歩かせます。 学習が終わって残るのが、観測から次の関節の目標角度を出す方策で、それを Arduino に書き込みます。
使っている道具と用語は次の通りです。
名前 |
何か |
|---|---|
PPO |
Proximal Policy Optimization。方策を少しずつ直していく手順(アルゴリズム)の 1 つで、1 回の更新で方策を変えすぎないように抑えるのが特徴です(論文、2017 年) |
MuJoCo |
Multi-Joint dynamics with Contact。関節でつながった体が、地面などと接触しながら動く様子を計算する物理シミュレータです。Roboti LLC が開発し、2021 年に Google DeepMind が取得して無償化、2022 年にオープンソースになりました(公式ドキュメント)。上のブラウザのシミュレーションもこれです |
mjlab |
MuJoCo の上で強化学習の環境を組み立てるフレームワークです。GPU で MuJoCo をたくさん並べて動かす MuJoCo Warp を使い、環境の書き方は NVIDIA の Isaac Lab に合わせてあります(mujocolab/mjlab)。mjlab での学習には NVIDIA の GPU が要ります(GPU が無い場合は 歩行方策を自分で学習する) |
unitree_rl_mjlab |
Unitree が公開している、mjlab で自社のロボットを学習させるコード(unitreerobotics/unitree_rl_mjlab)。本書はこれに、この機体の定義と報酬を差し込んで学習しました |
rsl_rl |
ETH チューリッヒの Robotic Systems Lab が公開している、ロボット向けの強化学習ライブラリです。PPO はこの実装を使っています(leggedrobotics/rsl_rl) |
sim2real |
シミュレーションで学習した方策を実機に持っていくこと。シミュレーションと実機は完全には一致しないので、ずれを見込んで学習します(下の「学習のコード」) |
方策の中身#
小さな多層パーセプトロン(MLP, Multi-Layer Perceptron。全結合の層を重ねた、 いちばん素朴なニューラルネットワーク)1 つだけで歩いています。Arduino UNO R4 でも毎周期推論できるサイズです。
入力(観測) |
87 次元 = 指令 (vx, vy, wz) ・歩容位相 (sin/cos) ・関節角 8 ・関節速度 8 ・前回 action(方策の出力)8、それぞれ 3 ステップ分の履歴 |
ネットワーク |
全結合 [96, 64]、活性化関数 ELU(Exponential Linear Unit) |
出力 |
8(各関節)。サーボ目標角 = home 角 + 0.25 × action。home 角は home 姿勢(立って歩き出す基準の姿勢)での関節角 |
制御周期 |
50 Hz(0.02 s)、歩容クロック 0.32 s |
センサ |
関節角・関節速度のみ。IMU(慣性計測装置。胴体の傾きや回転の速さを測るセンサ)は使っていない(この機体に無いため。胴体の姿勢は方策から見えていない。IMU を載せた版は IMU で姿勢を見て踏ん張らせる) |
外転関節(脚を横に開く関節)が無いので横移動(vy)はできません。旋回は左右の歩幅差で作ります。
シミュレーションでの性能: 前進指令 0.12 m/s で 0.120 m/s(0.48 体長/秒)、 最大の指令 0.15 m/s で 0.148 m/s。指令にほぼ追従します。旋回は指令 0.3 rad/s で 0.213 rad/s。対角トロットは 3.13 Hz(歩容周期 0.32 s)で、 速度によらず一定です。いずれも上のシミュレーションと同じモデル・同じ制御で 20 秒ずつ 5 回歩かせ、後半 10 秒の平均を取った値です。遅いのはサーボの無負荷回転数で決まる 機体の性質で、学習の失敗ではありません。
学習のコード#
学習は mjlab (unitree_rl_mjlab) の PPO(rsl_rl)で行い、ロボット定義・報酬・環境設定を差し替える overlay(上流のコードはそのまま使い、この機体に必要なファイルだけを上から被せる書き方)として 書いてあります:
ロボット記述一式(URDF(ROS などで使うロボットの記述形式)・ MJCF(MuJoCo のモデル形式)・メッシュ・RViz 設定、SolidWorks エクスポートから MJCF を再現するスクリプト付き): docs/os-on-arduino/code/13_quadruped/arduino_os_quad_robot
sim2real のために、摩擦(0.4〜1.1)・付加質量(電装ぶん 0〜250 g)・ ゼロ点誤差(±1.7°)・関節角(±8.6°)などをランダム化して学習したあと、 リセット姿勢・速度をさらに乱した fine-tune(ロバスト化)を重ねています。 だから組み立てで数度ずれても歩きます。
自分で学習し直す手順は 歩行方策を自分で学習する にまとめました。 報酬や速度上限を変えて回してみたいとき、そして GPU が無い場合の Google Colab での通し方はそちらです。
実機で歩かせる#
使うのは第13章のサンプルコードで、章ごとのサポート の手順で入手した
docs/os-on-arduino/code/13_quadruped/ です(このサイトの
code/13_quadruped/
も同じものです)。以下のコマンドは、docs/os-on-arduino/code にいる前提で
書いています。 学習済み方策は include/arduino_quad_policy.h に入っていて、
上のブラウザのシミュレーションと同じ方策です。
機体ごとに合わせる値は 3 つあります。サーボの ID は
組み立ての表 の通りに振り、回る向き(sign) は脚の組み方で
決まるので、本書の通りに組めば include/quad_calib.h に入っている値のままです。
残る ゼロ点は、脚をまっすぐにした姿勢でサーボの EEPROM(電源を切っても
消えない記憶領域)に書きます。
EEPROM に書くので、ファームウェアの値を書き換える必要はありません。
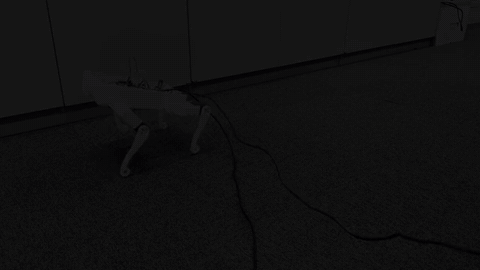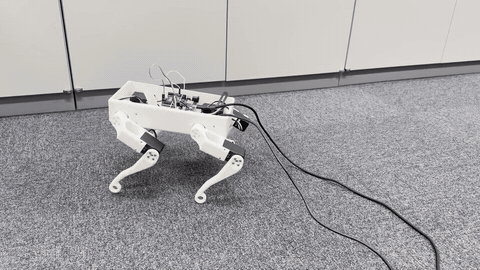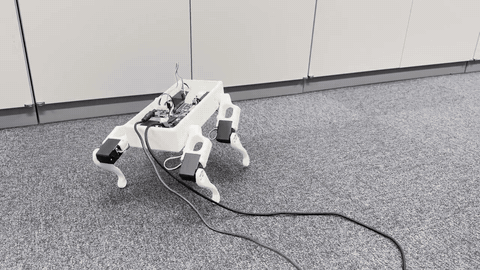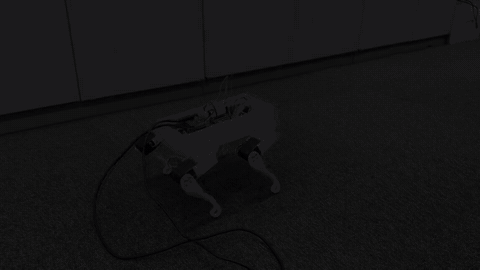
本書の実機(自作 OS で 8 個のサーボを制御)が歩くところ(1.5 倍速)#
1. 配線する#
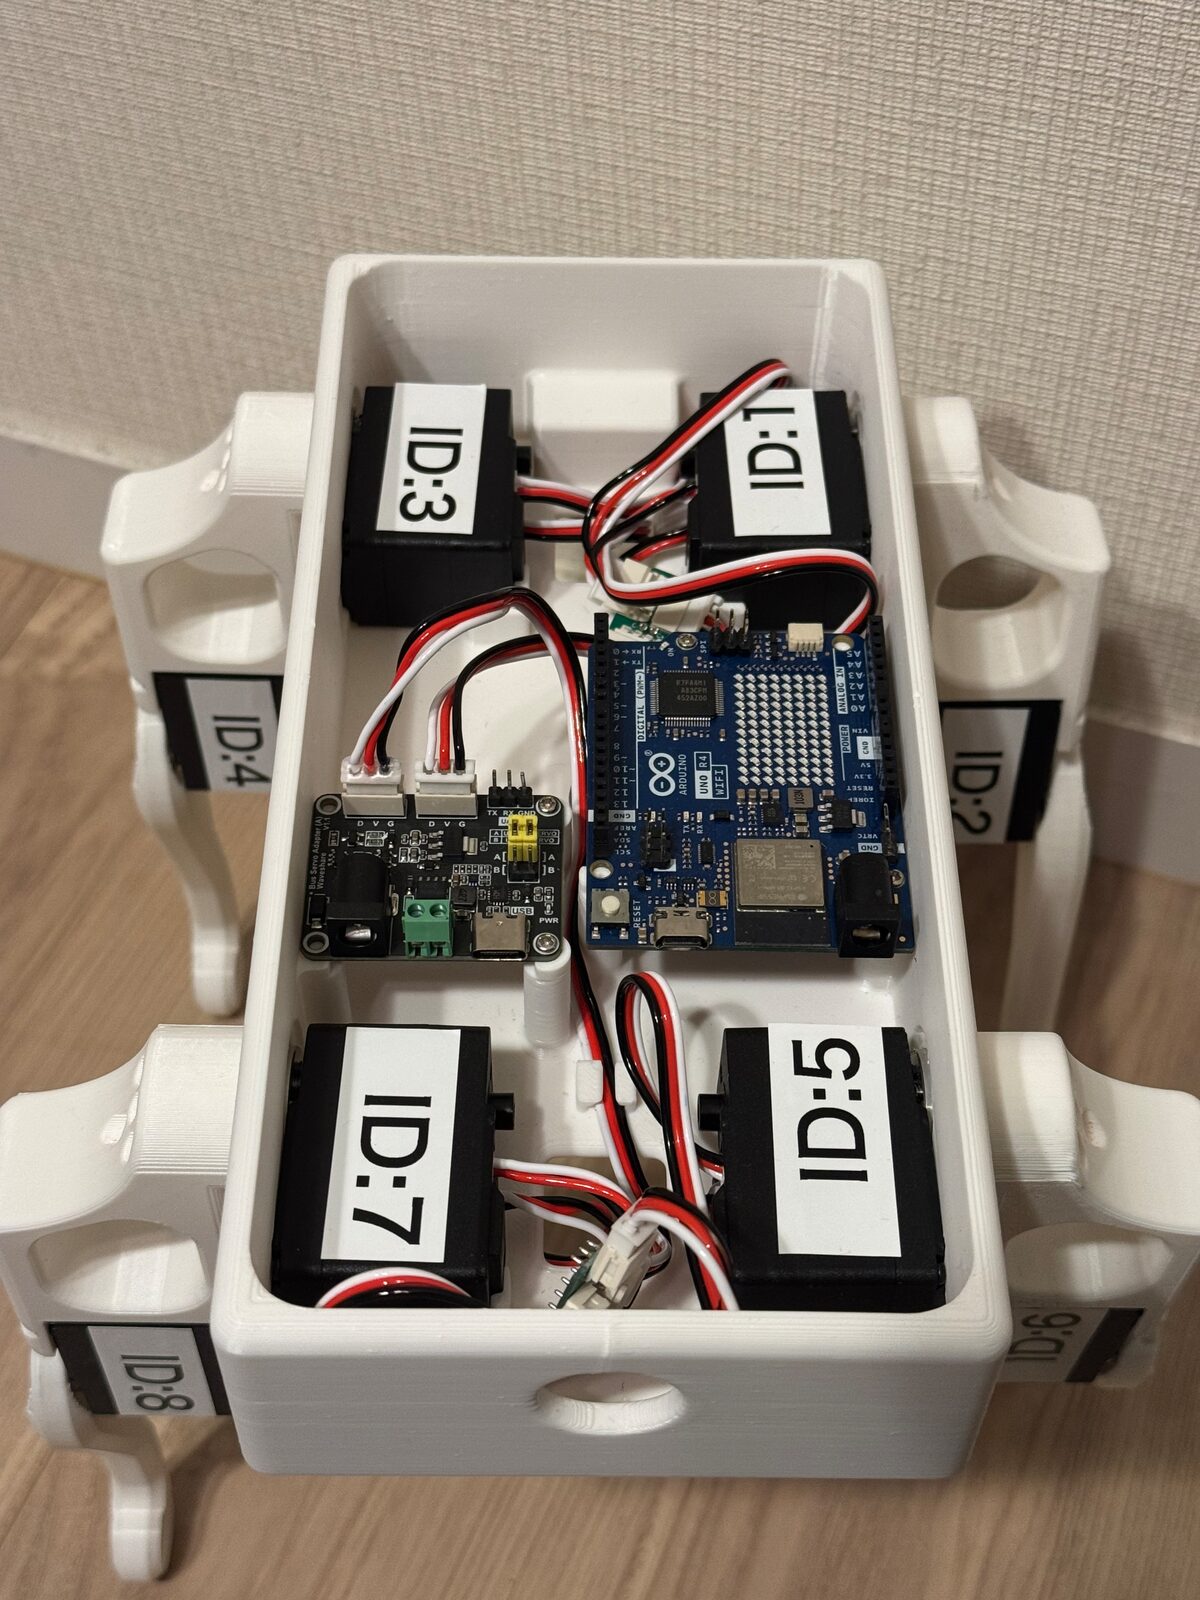
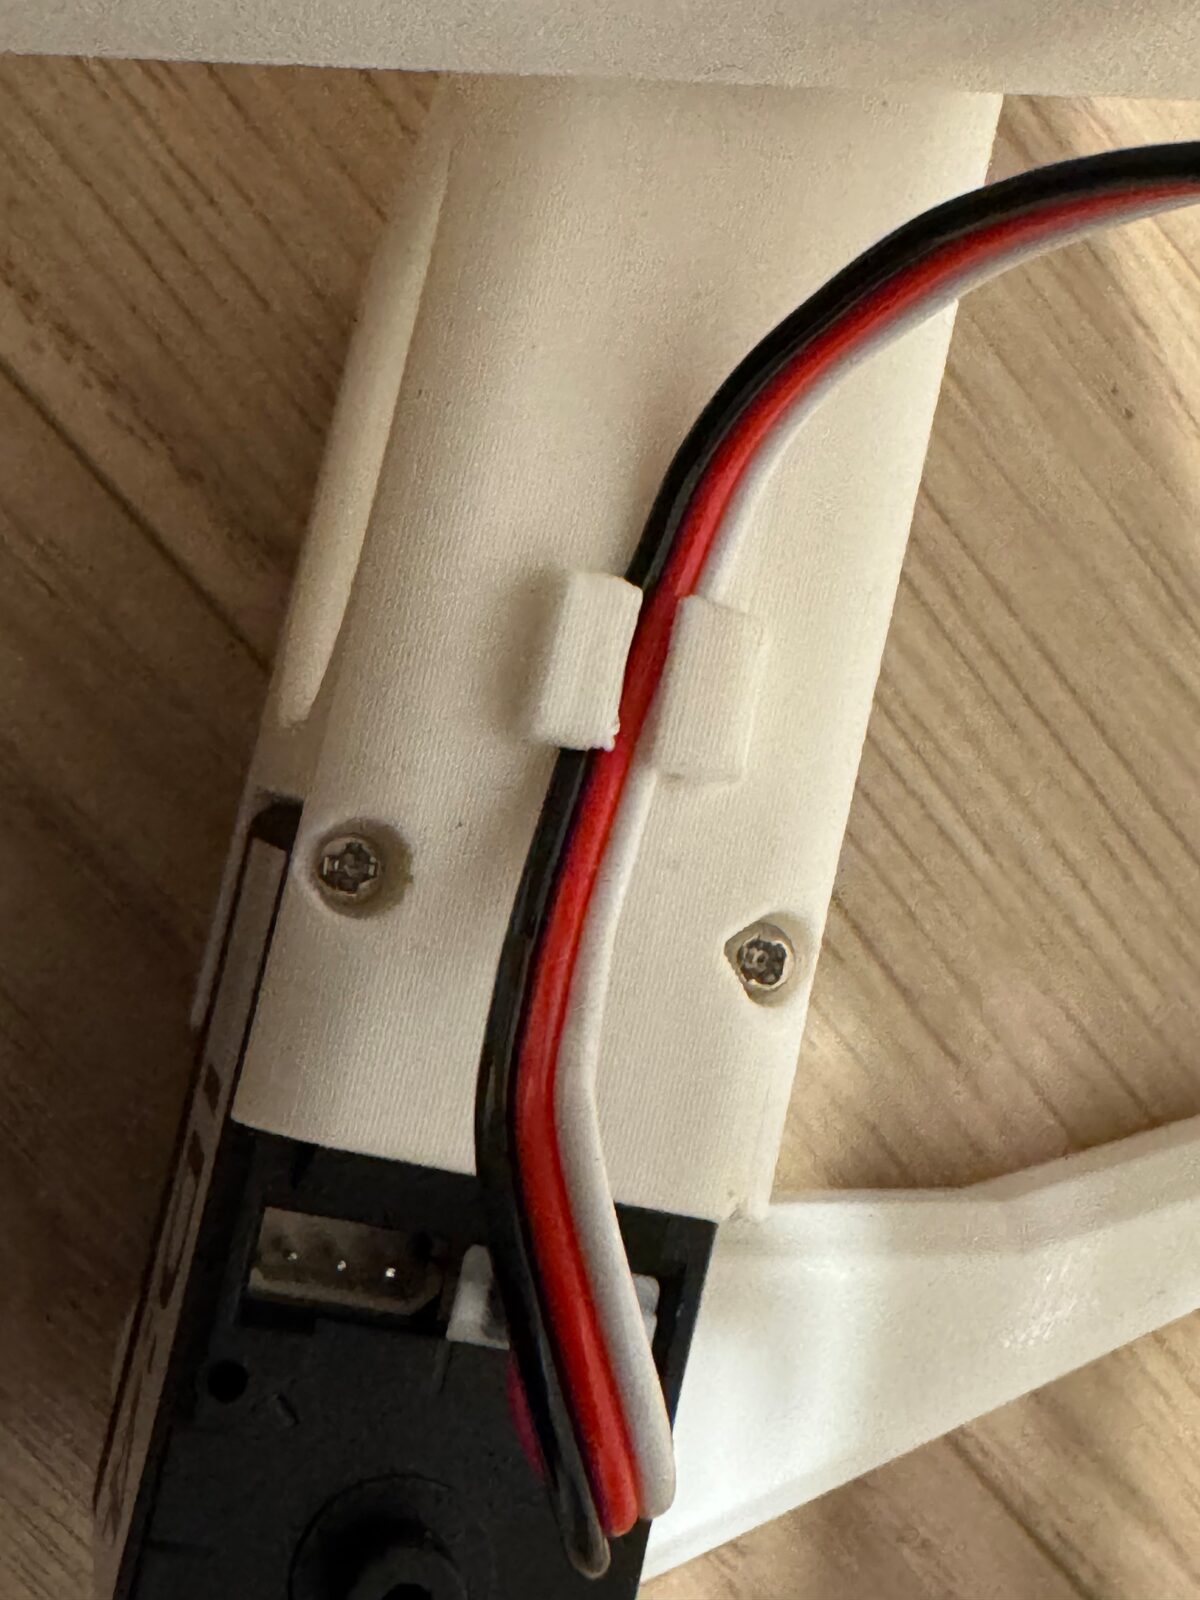
胴体の中に、ドライバーボードと Arduino UNO R4 WiFi を並べて置きます。8 個の サーボはドライバーボードの 3 ピンコネクタ(D V G)へ数珠つなぎにします。
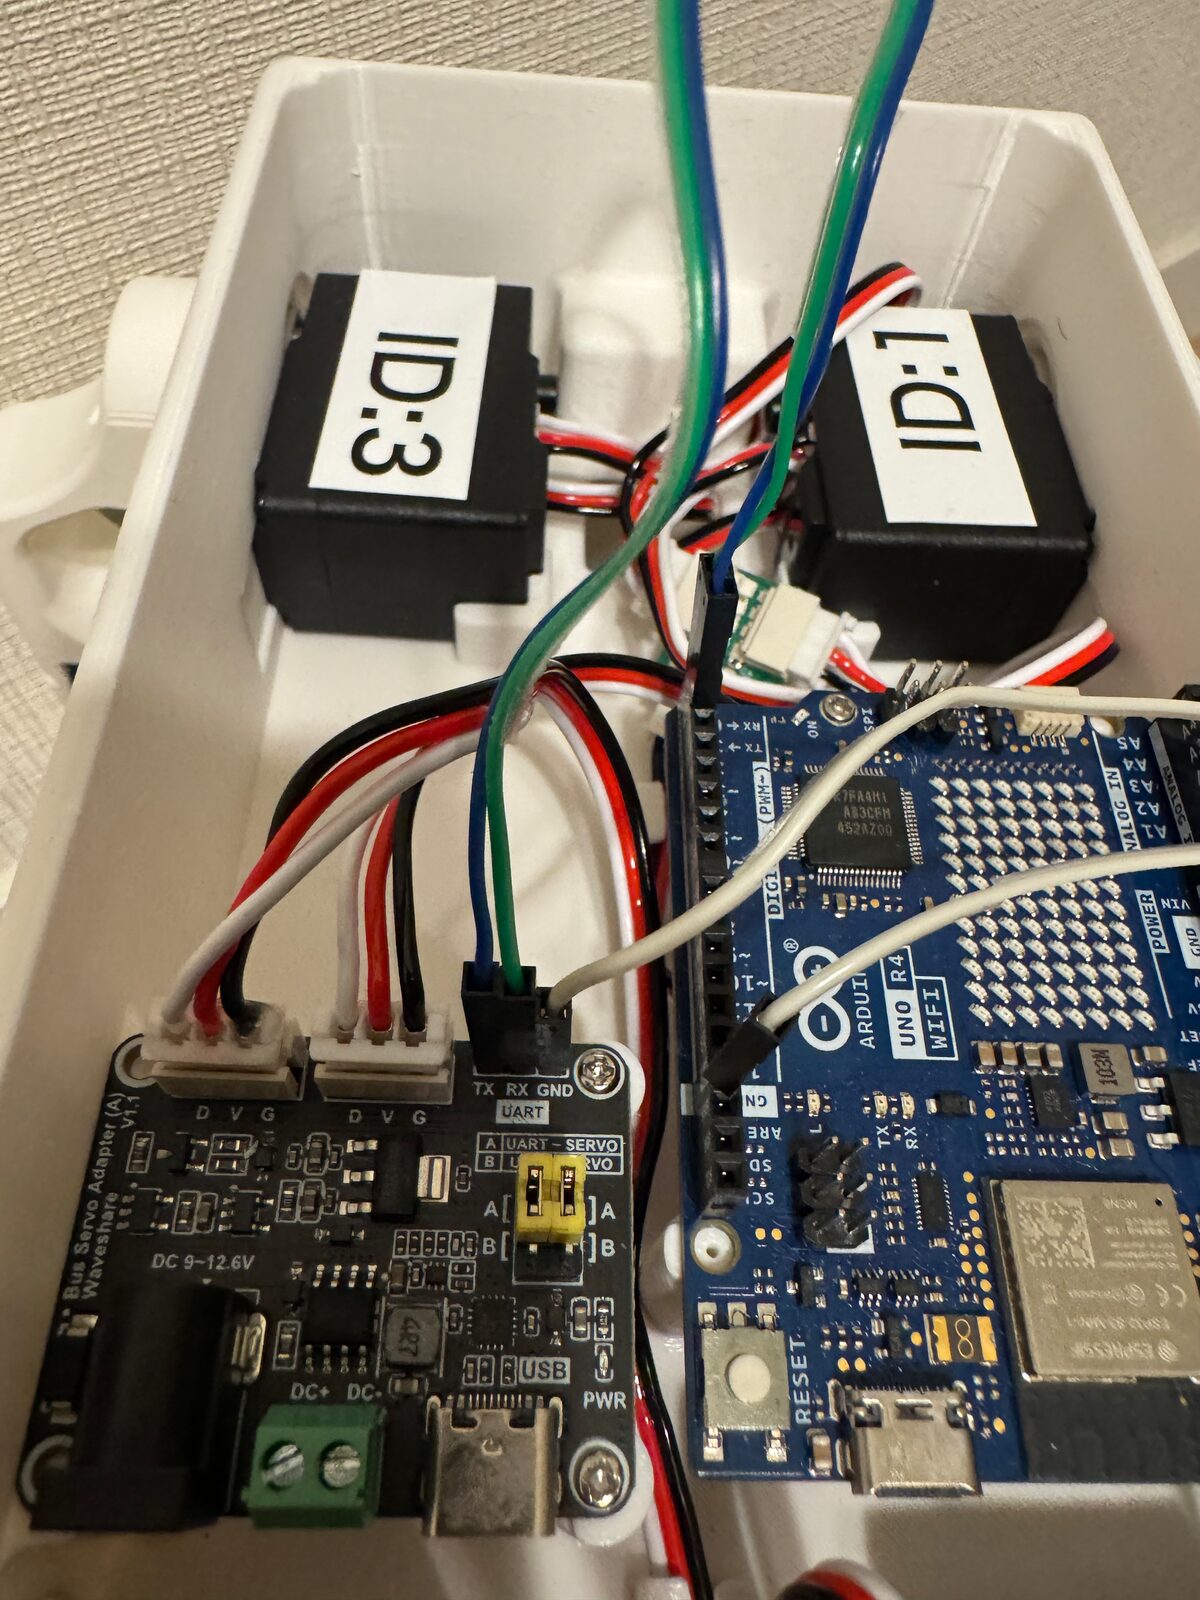
ドライバーボードの UART(シリアル通信)ヘッダと Arduino を 3 本でつなぎます。TX 同士・RX 同士 をつなぐのがこのボードの約束です(部品表(BOM)— 8 自由度四脚ロボット の「配線で先に知っておくこと」)。
ドライバーボード |
Arduino |
|---|---|
TX |
D1(TX→1) |
RX |
D0(RX←0) |
GND |
GND |
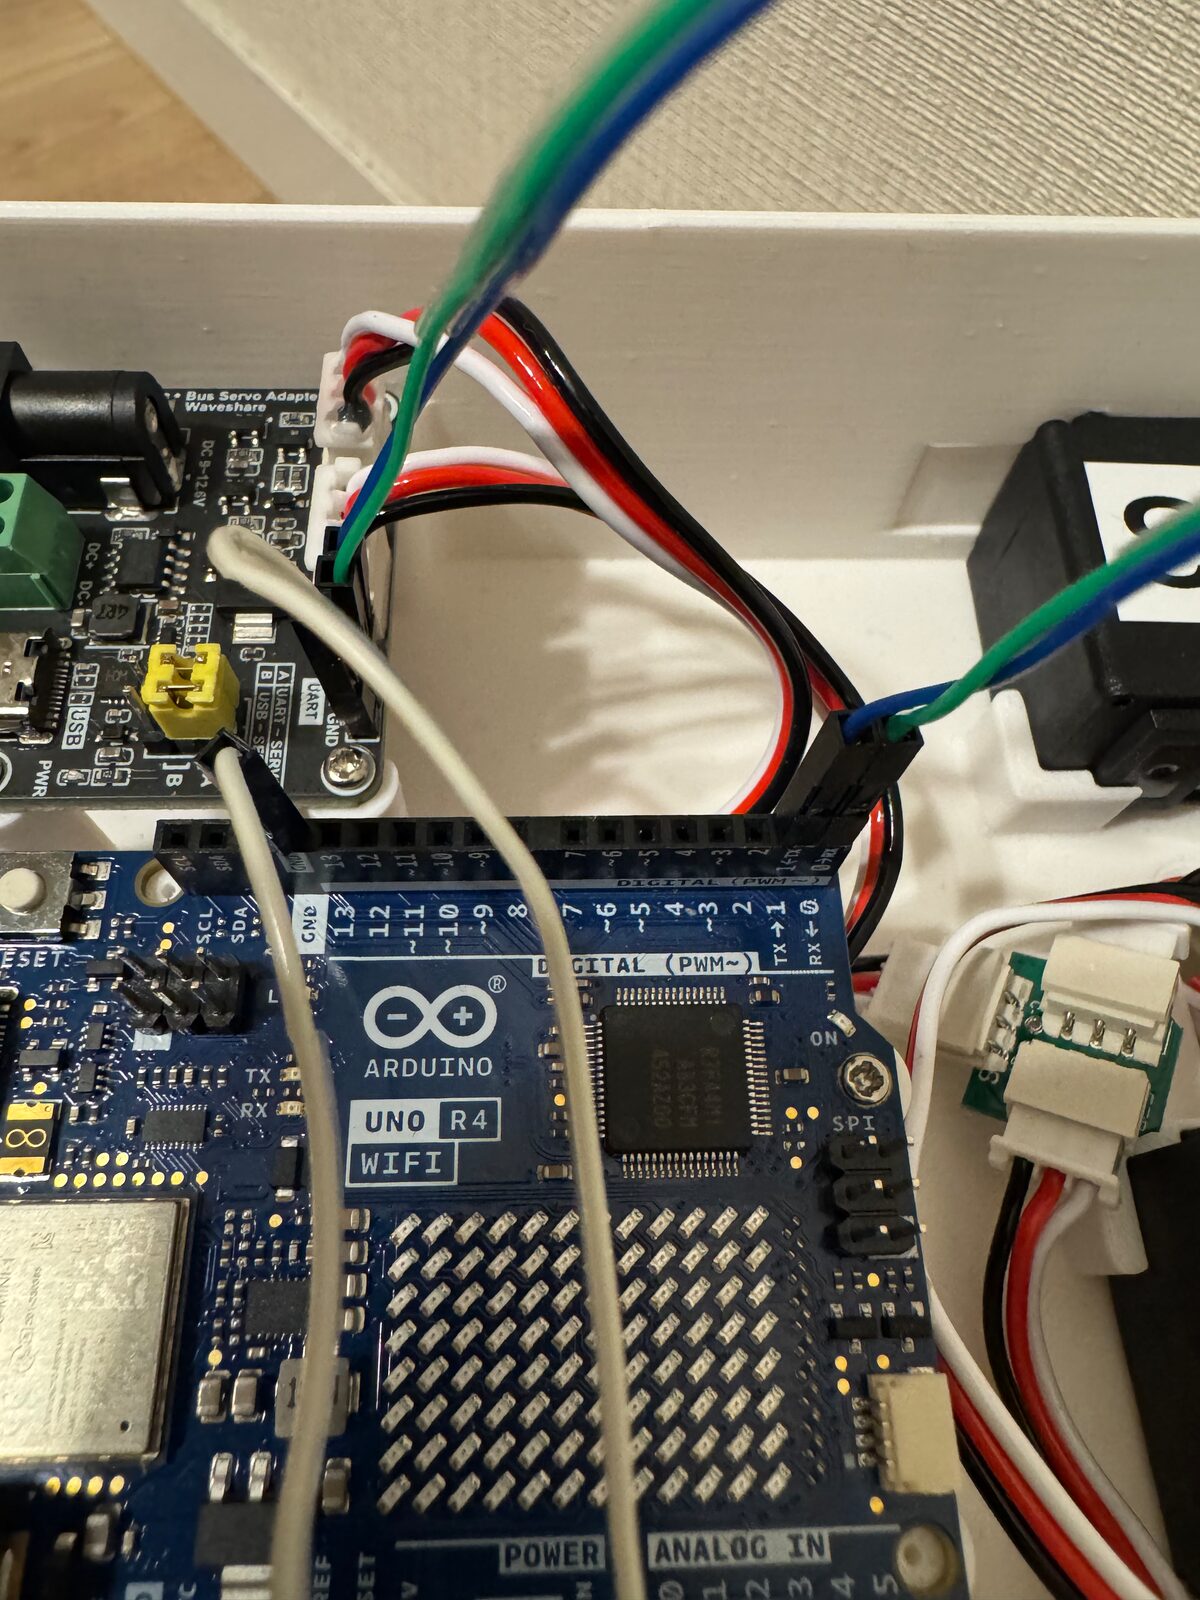
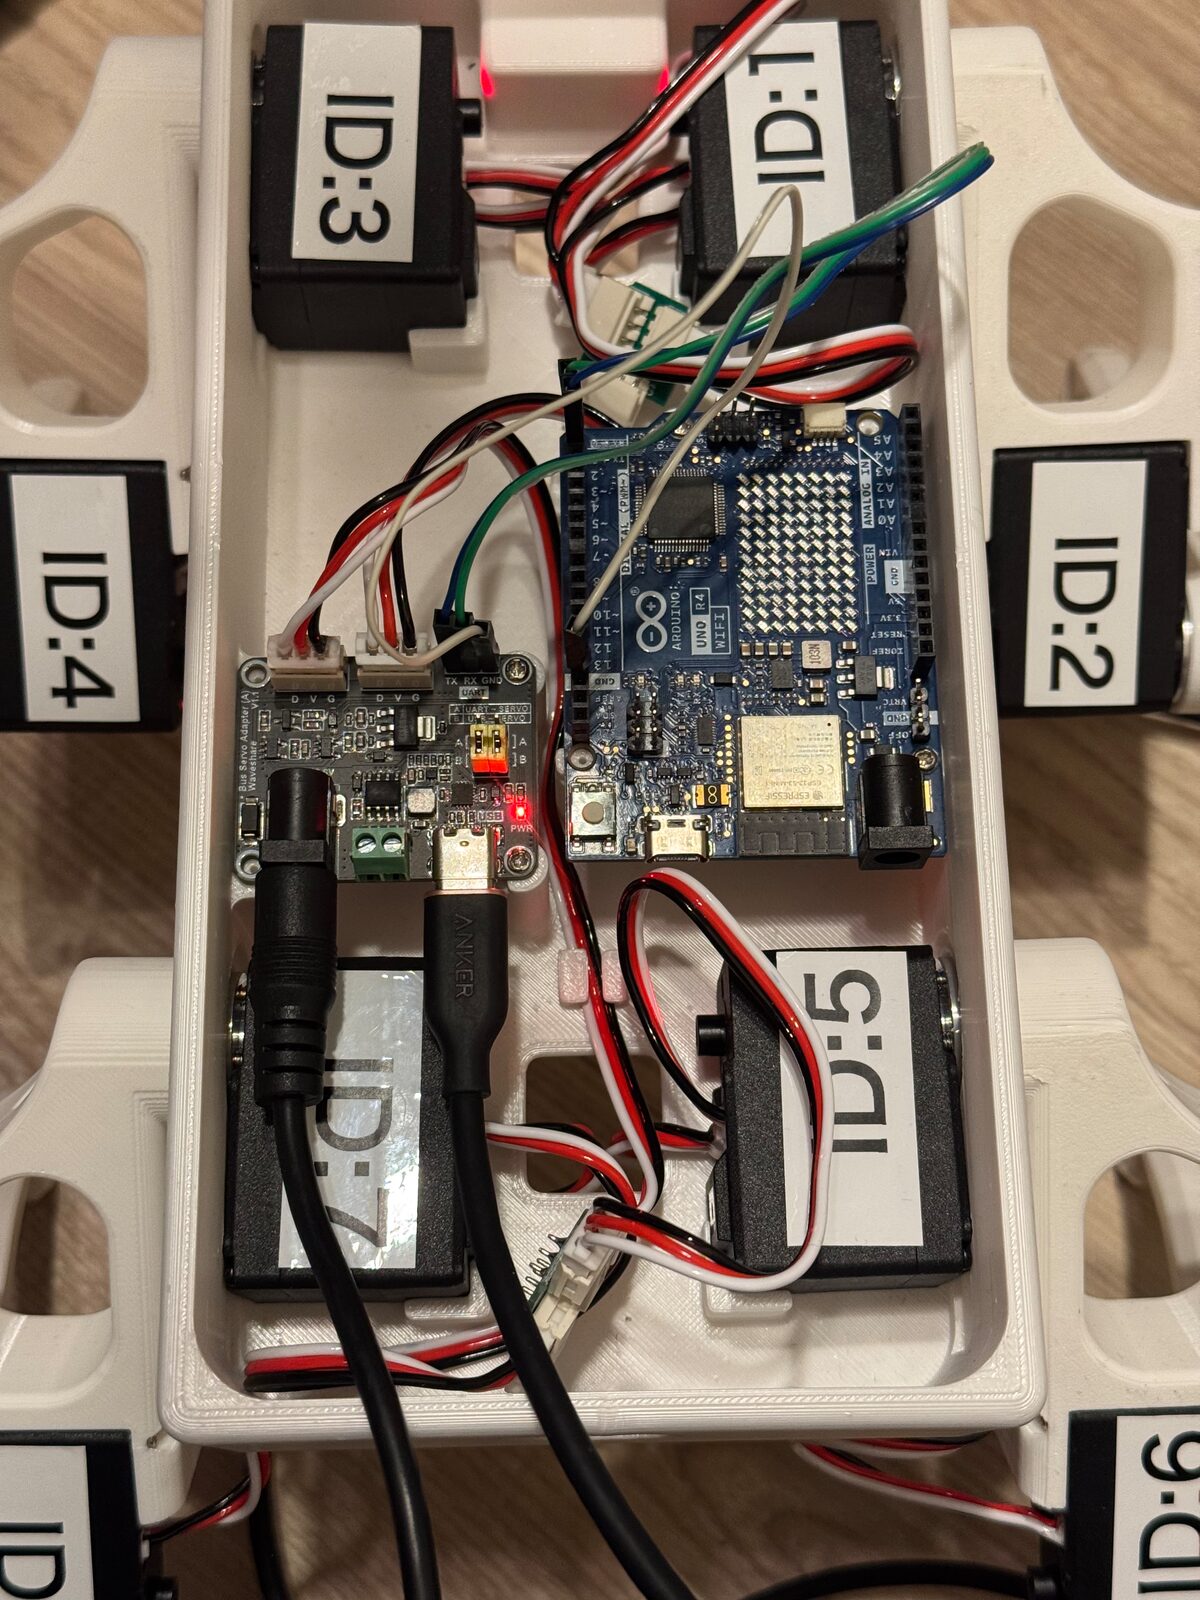
配線を終えたところ。ボードには電源(DC ジャック)と、PC から動かすときの USB Type-C をつなぐ#
2. PC からゼロ点を合わせる#
ドライバーボードのジャンパを B(USB-SERVO) にして、ボードの USB Type-C を PC につなぎます。Arduino は使わず、PC から直接サーボを動かします。
cd 13_quadruped/host
uv sync                                  # numpy と feetech-cli が入る

uv run python quad_host.py scan          # 8 個応答するか
uv run python quad_host.py zero          # 脚をまっすぐにした姿勢をゼロ点にする
zero はトルクを切ってから、4 本とも股から足先までまっすぐ真下に伸ばした姿勢を
待ちます(機体を手で支えるか吊るして行う)。CAD はこの姿勢が 0 度になるように
描かれています。Enter を押すと 8 個のサーボの EEPROM にゼロ点を書き、8 個とも
2048 と読めることを確かめます。電源を切っても残ります。
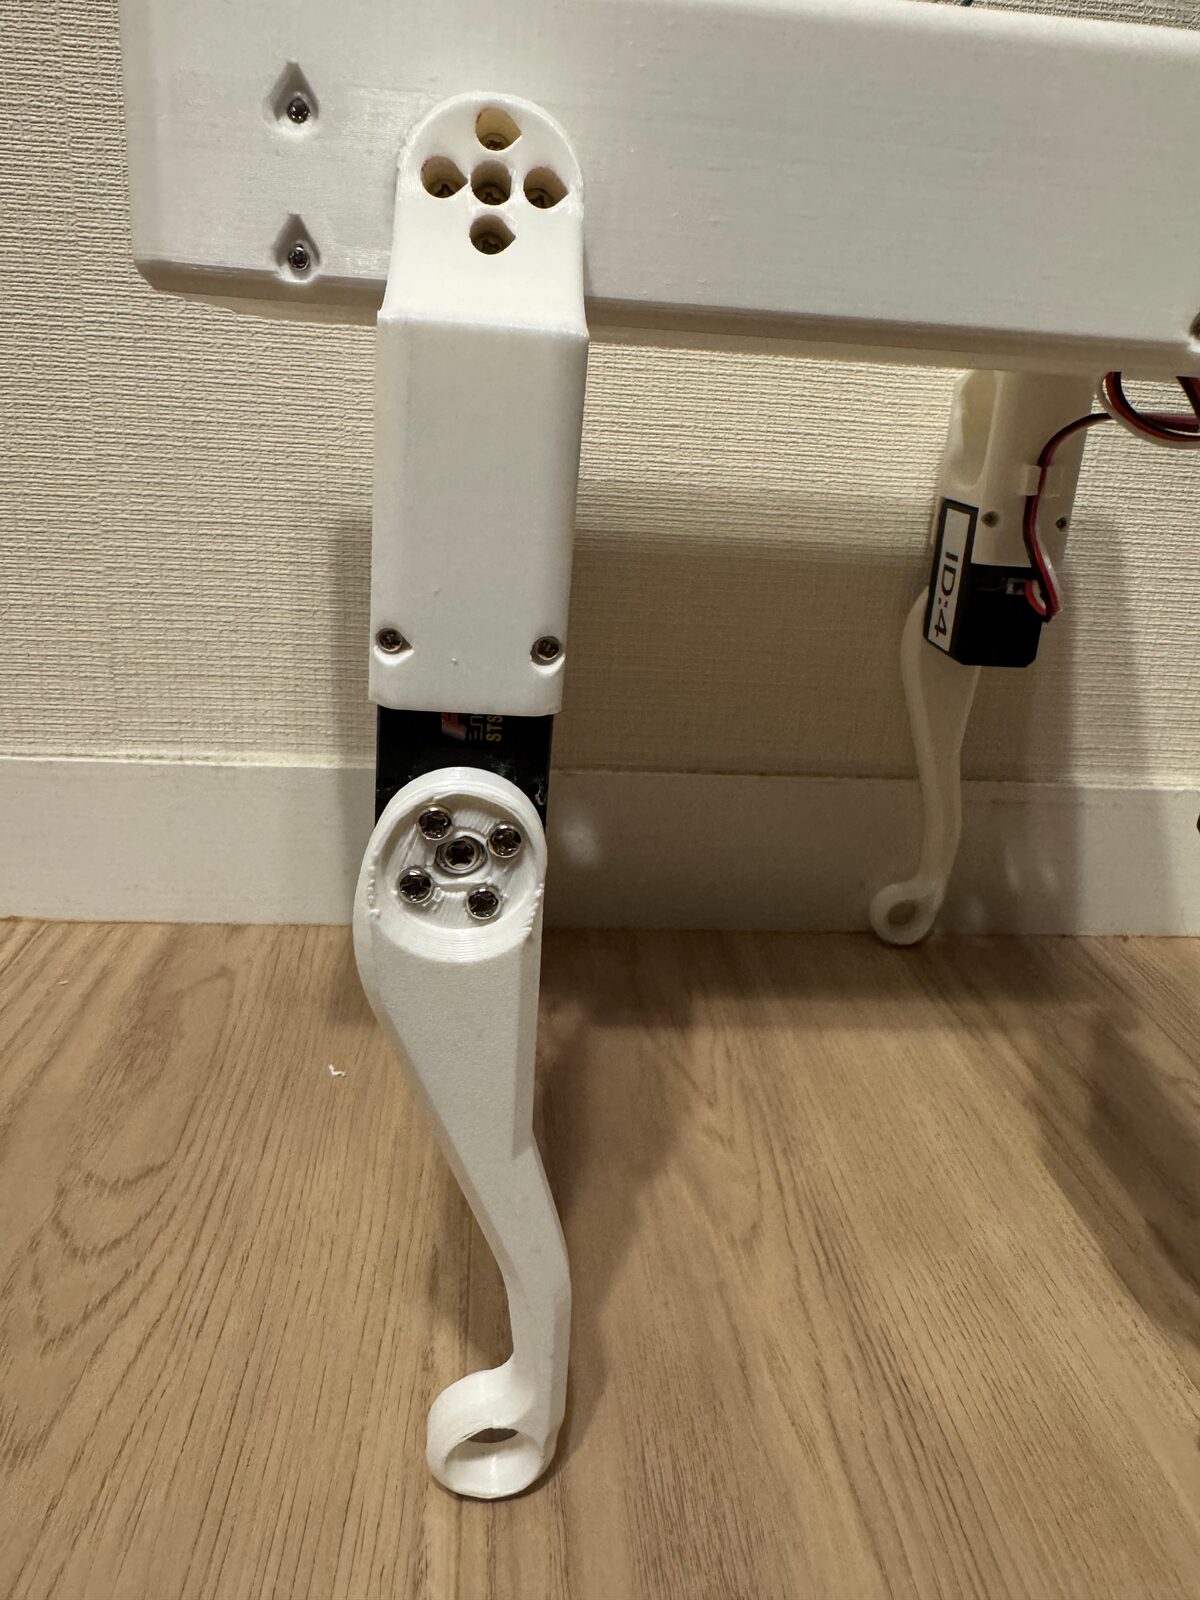
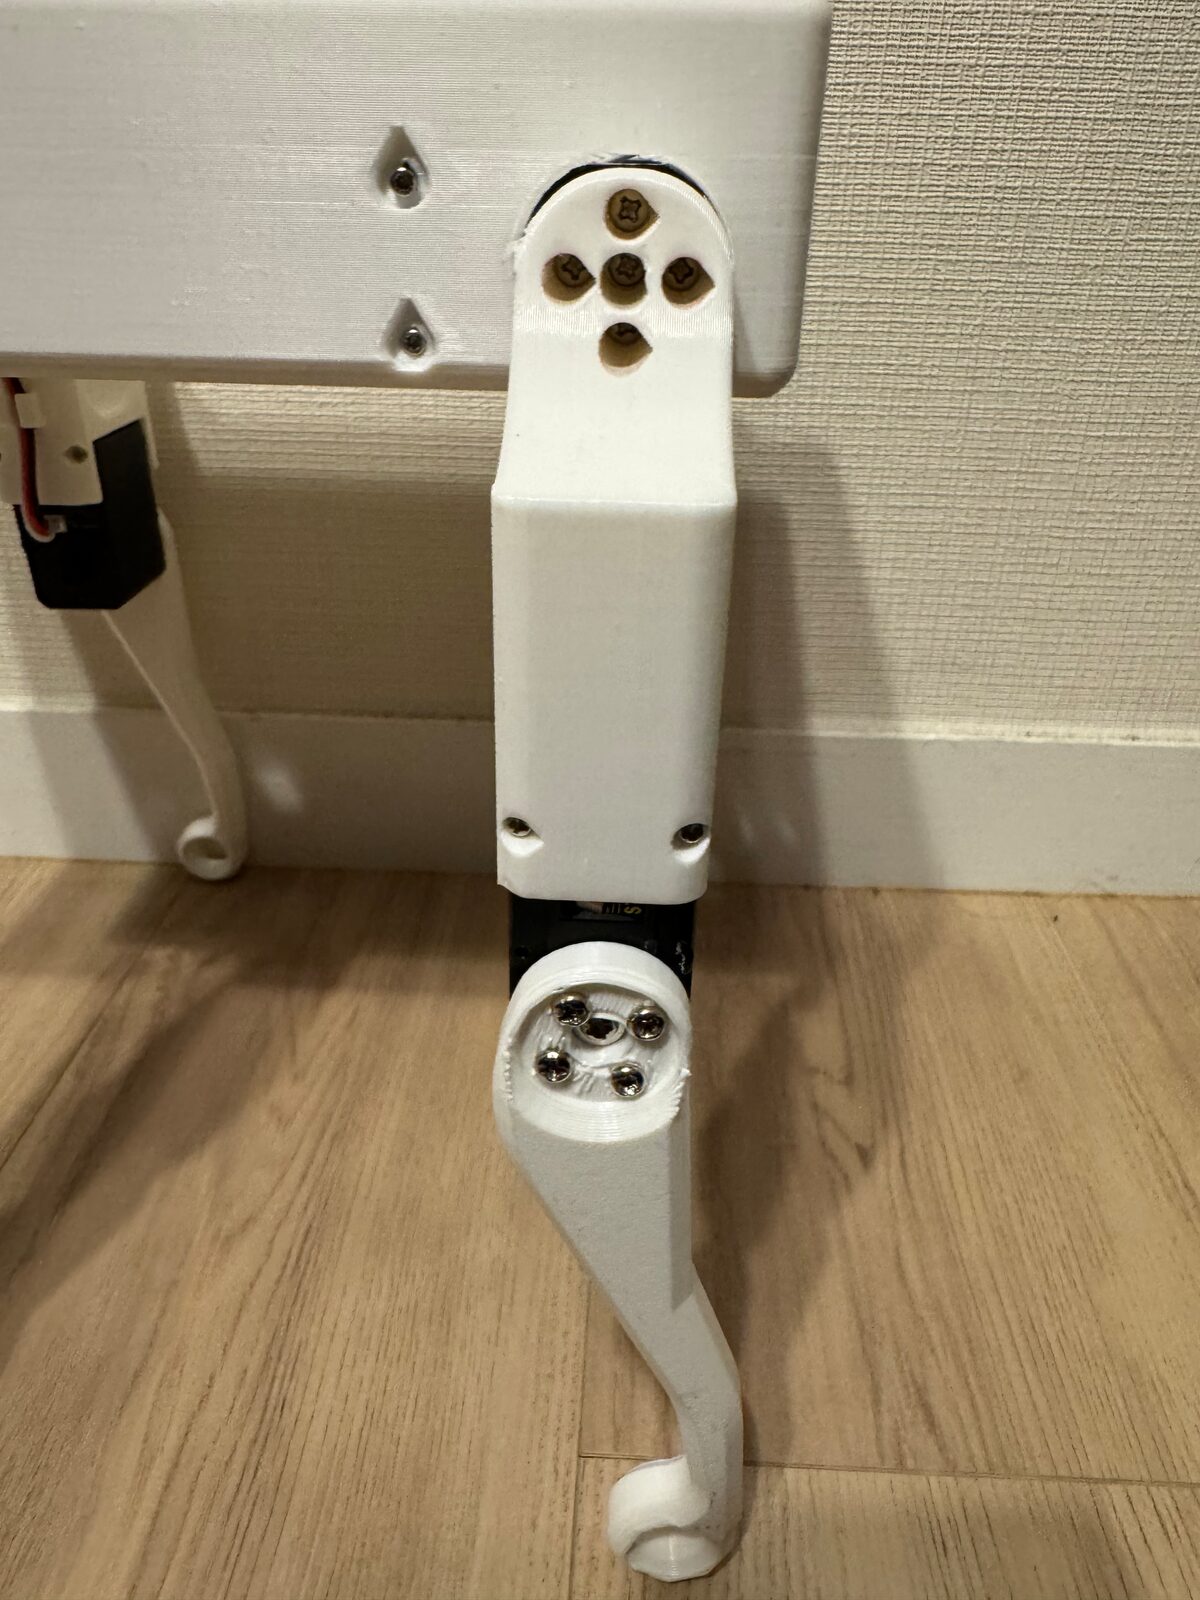
ゼロ点が入ったら、そのまま PC から立たせて歩かせられます。
uv run python quad_host.py stand         # home 姿勢で保持。Ctrl-C で脱力
uv run python quad_host.py teleop        # キーボードで歩かせる(PC が方策を回す)
stand はまず吊るして、4 本とも同じ格好で膝が後ろに引けていることを
確かめてください。1 本だけ鏡像になるなら、その脚の ID か組み方が違います。
teleop のキー操作は次の通りです。w を押すたびに前進速度が 0.02 m/s ずつ上がり、
space で止まります。
キー |
動作 |
|---|---|
|
前進速度を ±0.02 m/s |
|
旋回速度を ±0.05 rad/s |
space |
止めて home 姿勢を保持 |
|
全関節を 0 度(脚をまっすぐ)。吊るして使う |
|
止めて脱力し、終了 |
3. Arduino に書き込んで歩かせる#
ジャンパを A(UART-SERVO) に戻し、Arduino を PC に USB でつないで書き込みます。
cd ../..                                  # 2 で host に入ったので code に戻る
uv run pio run -d 13_quadruped -t upload
書き込みが終わると Arduino が起動し、2 秒かけて home 姿勢に立ち上がります。 ここからは方策を Arduino が回し、PC は速度の指令を送るだけです。キーボードで 操作するなら:
cd 13_quadruped/host
uv run python quad_host.py serial        # Arduino の USB シリアルへ速度を送る
キー操作は teleop と同じです。違いは 2 つあります。x で終えても脱力せず、
home 姿勢で立ったまま止まります。そして指令が 0.3 秒途切れると、Arduino が自分で
止まって home 姿勢を保持します(PC 側が固まったり、ケーブルが抜けたりしたとき)。
シリアルモニタから直接コマンドを打つこともできます
(docs/os-on-arduino/code で uv run pio device monitor -b 115200)。
コマンド |
動作 |
|---|---|
|
順運動学と逆運動学(FK/IK)の往復テスト。脚は動かない |
|
home 姿勢へ 2 秒で移って保持 |
|
本文 13.5 の sin/cos 歩行(学習なしの歩き方)。吊るして試す |
|
学習済み方策で歩く。例 |
|
全関節を 0 度へ移して保持。吊るして使う |
|
トルクを切る |
歩いているあいだ、毎秒こういう行が出ます(本書の実機で rl 0.15 0 のとき):
loop avg 5770 us max 5797 us late 0/51 skipped 0 read_fail 0
loop avg は 1 周の処理時間で、制御周期 20 ms(50 Hz)に収まっていれば十分です。
skipped は制御周期を落とした回数、read_fail はサーボが応答しなかった回数で、
どちらも 0 のままが正常です。増えるなら配線か電源を疑ってください。
警告
サーボ 8 個の電源は 12 V の AC アダプタかバッテリーから。PC の USB からは 絶対に取らない(1 個あたりストール 2.7 A)
standと最初の歩行はまず機体を吊るしてから。ID や組み方を間違えると、 下手に歩くのではなく暴れます
Tip
足裏にゴムかシリコンを貼ると滑りにくくなります。素の樹脂のままでも歩けますが、 フローリングのような硬くて滑らかな床では足が滑りやすくなります。
FAQ#
転倒から起き上がれる? — できません。IMU が無く自分の姿勢を観測できない ためです(学習しても成功率 1%)。IMU を載せる価値が最も高いのはここです。 IMU を載せて押しに踏ん張る版は IMU で姿勢を見て踏ん張らせる にありますが、起き上がりはまだ学習していません。
もっと速くならない? — 45 rpm のサーボに 0.19 m の脚という構成では 0.05〜0.2 m/s が素の実力です(シミュレーションでは最大の指令で 0.16 m/s)。律速はトルクではなく無負荷回転数なので、 速くしたければサーボか脚長の変更になります。